后端工程 ID 实践:一个号码需要承担多少事情
一个号码逐渐承担了存储、排序、路由、排查、隐私和数据治理的责任。理解今天的 ID 实践,就得看看这些要求怎样影响了最初那个简单的选择。
创作说明本文在撰写、排版润色、术语表达或图片素材上使用了 AIGC 辅助,内容经作者审校定稿。
后端工程 ID 实践:一个号码需要承担多少事情
“天地玄黄,宇宙洪荒”,除了启蒙识字,《千字文》还曾被借来给事物编号。《乾隆版大藏经》就按它的字序给经函编次,从“天”到“机”,共 724 函,每函 10 卷。一个“天”字号,要放回具体经藏的编排中,才知道它指向哪一函。用简短符号引用事物,远早于计算机;我们一直需要弄清的,是它在什么范围内有效,又怎样指向同一个对象。
今天给订单表加一列 id,仍然在回答这个问题。设为主键,让数据库自动递增,其他表和业务代码拿着它引用订单,这个方案可以工作很久。
变化通常来自使用范围的扩大。订单开始分库,几个数据库里的号码需要互相区分;对象还没落库,消息里就想先带上它的 ID;客服希望从号码看出一点信息,对外接口又不希望暴露单量。数据进入数仓以后,我们还希望任务重跑一次,原来的订单仍然是原来的订单。
一个号码逐渐承担了存储、排序、路由、排查、隐私和数据治理的责任。理解今天的 ID 实践,就得看看这些要求怎样影响了最初那个简单的选择。
先从一张订单表开始
只考虑单库,由数据库分配递增整数,有很充分的理由:它紧凑,生成机制现成,也容易排查。订单改了收货地址和状态,其他表仍然可以用同一个值引用它,可变属性与稳定身份被分开了。
主键也可以直接使用业务属性或属性组合。Codd 的关系模型论文讨论的就是能唯一识别元组的属性或组合,并未规定额外的整数 id 列。如果业务键在需要的范围内稳定、唯一,直接使用它很自然;如果它以后需要修订,独立代理键则能让其他引用少受影响,代价是维护两者的关系。
在存储层面,我们还经常听到两条建议:主键尽量短,最好有序。它们分别解决不同的问题。
长度的成本会传到哪里
InnoDB 通常以主键建立聚簇索引,叶子节点保存完整行。二级索引保存索引列和对应主键,再通过主键找到行数据。因此,主键变宽,增加的不只是自身的索引开销,多个二级索引也会携带更宽的定位信息。这正是 MySQL 官方建议短主键的直接原因。
相同缓存能容纳的记录少了,扫描和维护同样的数据量,就可能访问更多页面。二级索引越多,这份成本越值得留意。
PostgreSQL 默认将完整行保存在 heap 中,普通索引通过 TID 定位堆元组。无关索引不会仅仅因为主键变宽就自动复制它;主键自身、引用它的外键列和相关索引,仍然需要支付宽度成本。
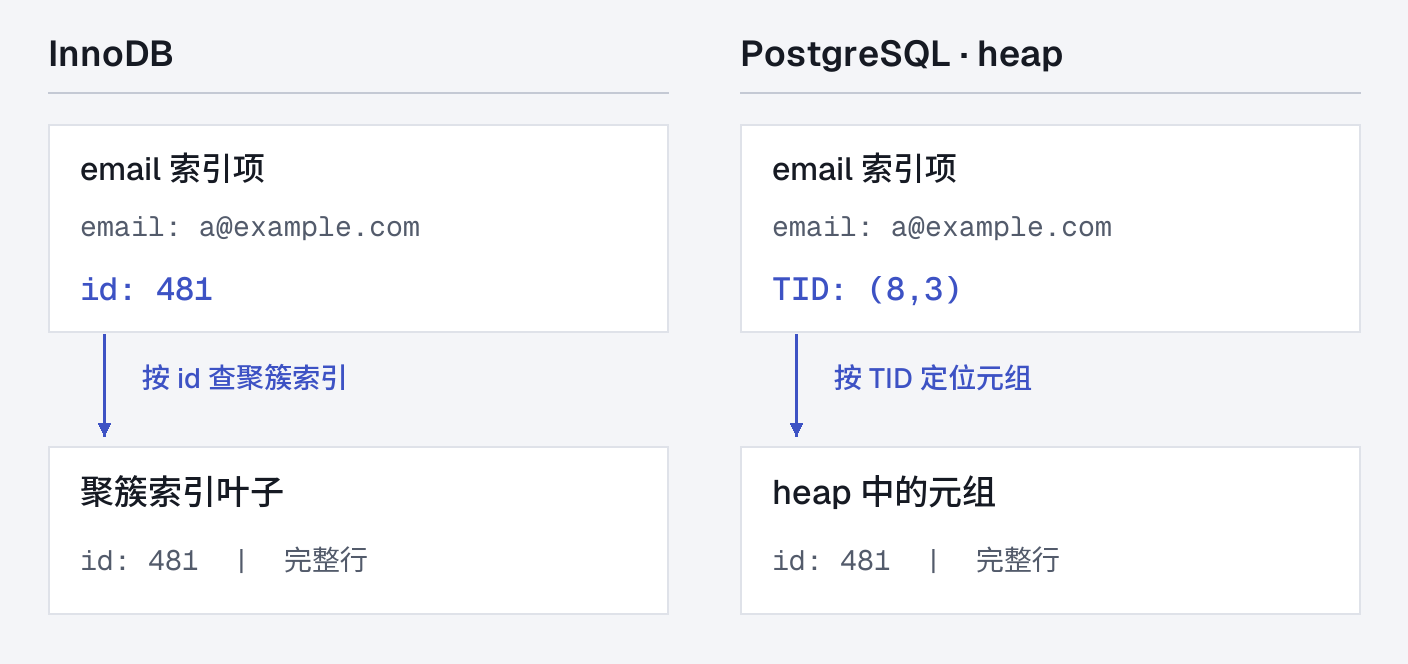
图 1:同样是从 email 索引查找订单,两种存储组织使用的行定位信息不同。
所以,紧凑的键在两者中都有价值,成本传播的方式却不一样。容量、唯一范围和生命周期确定以后,再比较候选类型的宽度,才能避免为节省几个字节而提前引入扩位迁移。
写入为什么喜欢相邻的值
索引按键值组织。新值大致相邻,写入通常能集中在较少的页面;随机值则会访问更分散的位置,影响缓存工作集、页利用率与维护开销。
这也是自增键常见的收益。它没有“保护 B 树不被破坏”,而是在既定存储组织里提供了较好的写入局部性。讨论 UUID 时,也应分别考虑位宽、值的分布和存储表示:128 位值、随机 UUIDv4、36 字符文本,影响的是不同层次的成本。
有了这些条件,单库里的递增整数并不需要急着更换。真正让唯一性问题发生变化的,是第二个数据库。
订单分库以后,号码归谁分配
假设两套数据库都从一开始给订单编号,各自内部没有问题,但其他服务拿到一个 123,已经无法直接确定是哪张订单。
我们可以保留上下文,让身份变成“来源加本地号码”;也可以统一分配号码,让各个数据库使用不重叠的空间。前者把来源带入引用和解析,后者需要有人管理分配。选择之前,值得把逐渐浮现的要求集中摆一下:
| 关切 | 需要明确的问题 |
|---|---|
| 唯一性 | 号码在哪个命名空间、多久之内不允许重复?采用受管理空间,还是概率保证? |
| 身份稳定性 | 改名、更新、迁移和恢复以后,哪些对象保留原来的 ID? |
| 独立生成 | 多个节点能否各自发号,断网需要继续工作多久? |
| 自增 | 是否使用计数器或序列分配,序列由谁维护? |
| 有序与单调 | 需要大致按时间聚集,还是在规定范围内后发的号必须更大? |
| 连续性 | 是否允许跳号,取消和失败怎样体现在编号里? |
| 存储成本 | 键宽、分布、缓存和分片方式怎样影响读写? |
| 吞吐与可用性 | 需要怎样的吞吐、尾延迟和故障容忍时间? |
| 容量与寿命 | 容纳多少生成器,每时间片多少号码,何时耗尽? |
| 难预测、难枚举 | 能否根据已知号码推测其他有效号码,遍历成本是多少? |
| 信息暴露 | 是否允许公开生成时间、规模、类型、节点和关联关系? |
| 自描述、校验与认证 | 要辨认类型、检出抄写错误,还是验证内容与发行方的关联? |
| 表示与兼容 | 原始位宽、字符串长度、字符集和跨语言类型如何约定? |
| 重算稳定性 | 同一来源身份再次处理时,怎样保留已有引用? |
| 可演进性 | 换算法、扩位或迁移以后,旧号码怎样继续被解释? |
这些要求有不同的优先级。比如自增、单调和连续,就不该捆成一个目标:PostgreSQL sequence 的取号不会随事务回滚退回,多会话缓存也可能让返回值交错出现。如果业务必须逐号相接,还得定义取消、失败与作废的处理,并选择合适的分配和确认时点。
从一次领一个,到一次领一批
统一发号很容易理解:节点先向权威服务拿到号码,再进行自己的工作。Flickr 的 ticket server 使用 MySQL 自增能力独立发号,并通过奇偶数划分两台服务器的空间,就是这种管理思路的一个公开实践。
如果每个号码都要远端申请,网络和持久化会进入请求路径。把申请单位扩大,就得到了号段:A 领取 1 到 1000,B 领取 1001 到 2000,各自在本地消耗。只要分配过程可靠地维护范围不重叠,就不必每次发号都协调。
A 发出 1,B 发出 1001,然后 A 再发出 2,这三个号码都唯一,观察到的结果却不是单调的。A 重启后若丢弃未使用部分,还会留下空洞。这些现象来自预分配本身,属于选择时就应当接受的成本。
耗尽时才领取下一批,会在切换处暴露延迟,于是可以后台预取,用两份 buffer 轮换。美团 Leaf 的号段模式,就将预分配和预取用于减少请求路径上的协调及切换延迟。预留越多,通常能容忍更长的上游故障,也会增加未使用空间和状态管理成本;余量耗尽以后,仍然要申请新的范围。
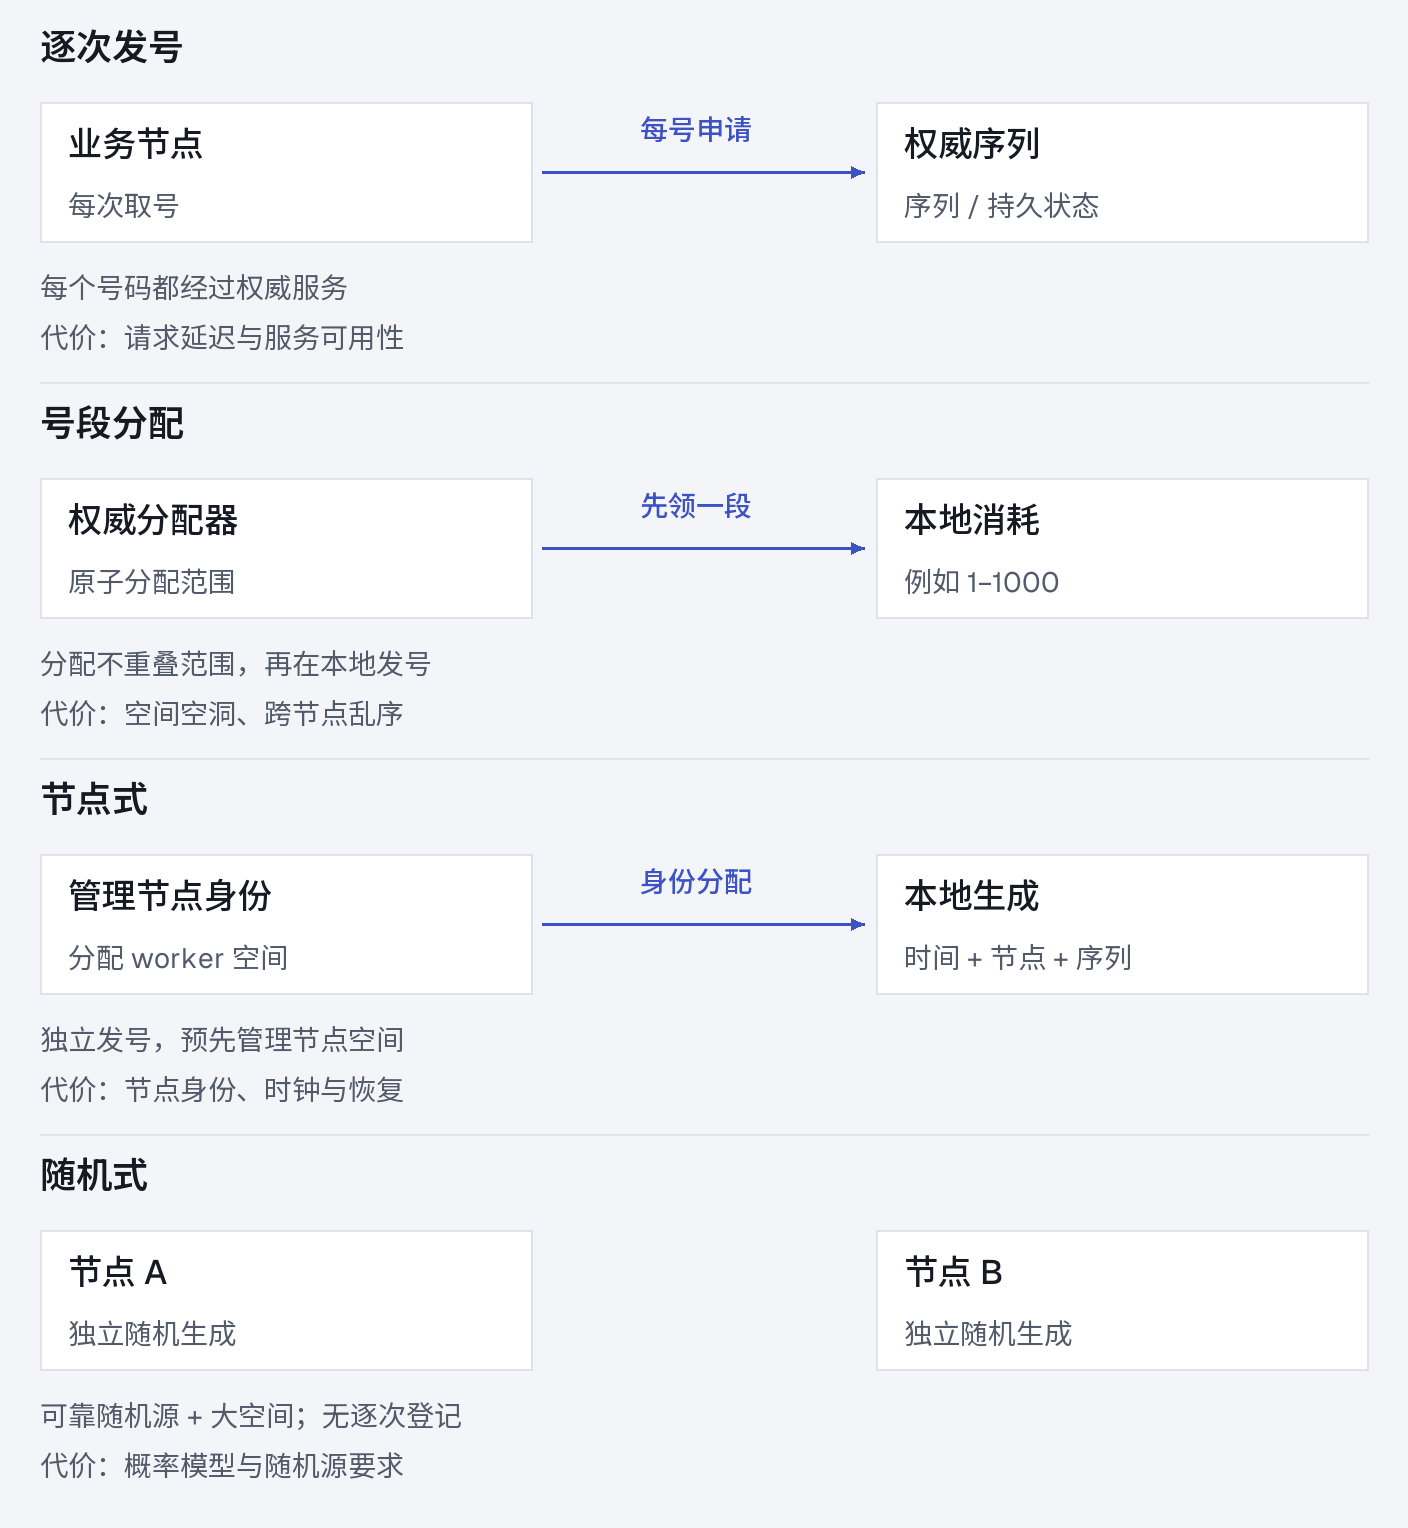
图 2:四种可以并存的分配方式,区别在于唯一性的依据和协调发生的位置。
号段管理的是明确的区间。我们还可以预先给节点分配空间,或者扩大随机空间,让节点独立选择号码。这就有了另外两条常见路线。
时间、节点、序列和随机数,分别换来了什么
在固定长度里划分空间
经典 Snowflake 常见的布局是 1 位保留/符号位、41 位毫秒时间、10 位节点和 12 位序列。高位时间让相近时刻生成的值大致聚集,节点字段区分并行生成器,序列区分同一节点在同一时间片内发出的多个号码。
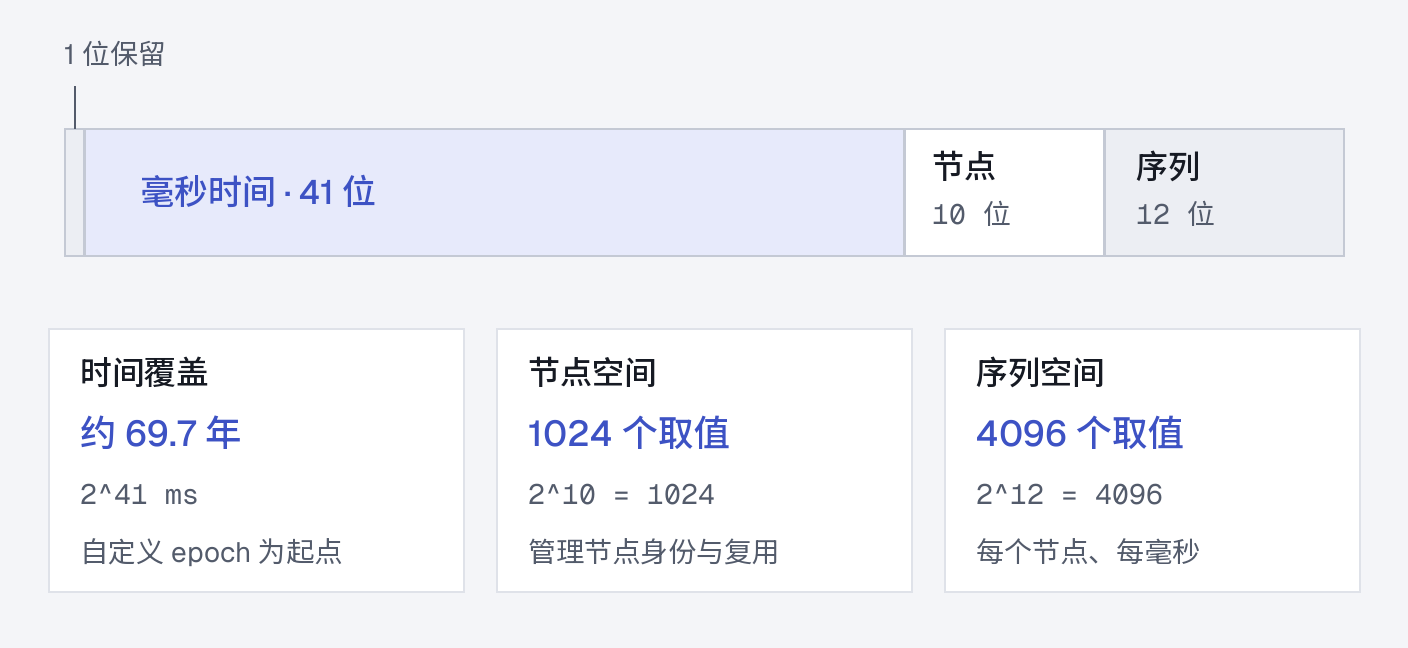
图 3:固定总长度下,各字段共享一份位数预算;图中是经典布局的一种分配。
41 位毫秒时间覆盖约 69.7 年,10 位节点字段有 1024 个取值,12 位序列在每个节点每毫秒有 4096 个取值。若固定总长度,增加节点位数就要从其他字段取空间。自定义 epoch 能安排时间范围的起点,时间字段终究仍有耗尽的一天。
片内容量也需要独立评估:每秒平均发号量不高,仍可能在某个毫秒耗尽序列。这是结构容量与请求分布的关系,实际吞吐还受到程序、并发和部署方式影响。
Twitter 在 2010 年介绍 Snowflake 时,64 位兼容、近似排序与可用性共同影响了设计;启动时仍借助 ZooKeeper 确定 worker 身份。Instagram 采用相似的时间/分片/序列组合,却把生成放进已有 PostgreSQL,以减少小团队要维护的独立组件。
已有基础设施与维护能力,和位布局一样,决定了方案是否合适。两套相似的号码结构,完全可以有不同的部署方式。
把空间放大,减少对明确分区的依赖
如果不想精细管理节点编号,可以使用足够大的空间,让各节点从可靠随机源独立生成。唯一性承诺随之建立在随机源、实现和碰撞概率上,省下了逐次登记或明确划分区间的工作。
| 方案 | 主要构成 | 空间分配的侧重点 |
|---|---|---|
| UUIDv4 | 128 位,包含 122 位随机空间 | 为独立随机生成保留较多空间。 |
| UUIDv7 | 48 位毫秒时间,另有版本/变体及 74 位随机或单调性辅助空间 | 在标准 UUID 长度内兼顾时间局部性。 |
| ULID | 48 位毫秒时间+80 位随机空间 | 兼顾时间与易排序的文本表示。 |
| KSUID | 32 位秒级时间+128 位随机空间,共 160 位 | 用更大总长度保留较多随机性。 |
| MongoDB ObjectId | 4 字节时间+5 字节进程级随机值+3 字节计数器 | 用进程级空间与计数,形成较紧凑的近似时间序标识。 |
加入时间字段,可以让随机生成与局部聚集共存。UUIDv7 已于 2024 年标准化,PostgreSQL 18 也提供了内置 uuidv7()。同毫秒的排序则要看实现:剩余空间可以使用随机数据,也允许包含计数器等单调性辅助结构。
还有名称派生的路线:同一命名空间与规范化名称,按约定算法重复得到同一个值。它把重点放在可复算性上,适合后面要说的补数与重算;输入名和规则本身的稳定性,也会成为身份的一部分。
局部聚集的收益,到了分片以后会怎样
前面讨论 InnoDB 时,有序键的收益是让写入集中在较少页面。如果存储本身也按键范围分布到不同节点,集中又可能变成负担:高写入表使用递增键,新请求会不断涌向末端区间。
Spanner 的官方指南因此建议考虑 UUIDv4、反转位序列,或调整复合键顺序来分散写入。单机页面的局部性与跨节点的负载分布,优化的是不同尺度。选择时间有序方案之前,需要确认我们希望写入在哪一层聚集、在哪一层分散。
号码的存储与传递还可以分别安排。128 位原始值、原生 UUID/二进制类型、36 字符文本,对应不同表示成本;Base32、Base62 也只是编码选择。跨语言时则需要约定整数范围,Discord 的 HTTP API 就将 Snowflake 表示为字符串,避免部分语言的大整数精度问题。一旦先用精度不足的类型接收,后来再转成字符串也无法补回丢失的位。
存储用上时间局部性以后,业务很容易进一步拿 ID 做分页、排序或增量位点。这里恰好藏着另一个常见问题。
取号顺序怎样变成了“数据已经齐了”
考虑两个并发事务:
事务 A:取得 ID 100 ───────────── 提交
事务 B:      取得 ID 101 ── 提交
A 先拿到较小的号,B 却先提交。如果增量任务看到 101 就推进水位,以后只查更大的 ID,迟提交的 100 就可能被跳过。即使使用同一个自增生成器,这个过程也成立:发号序被误当成了此前数据完整的证明。
物理时间无法直接补上这份保证。机器时钟可能有偏差,生成时点也可能在对象构造、事务执行或提交之前。某些实现为了回拨处理或容量,还会提前使用未来时间。百度 uid-generator 的公开设计就讨论了借用未来时间与预生成。
所以,需要大致聚集的索引、会话内的消息序,以及跨节点的事务提交序,应当分别选择机制。IM 只要求一个会话内有序,就可以围绕会话组织序列;Spanner 的外部一致性则依赖事务协议和时间基础设施。若还需要顺序符合因果关系,Lamport 所讨论的因果先后又是进一步的约束。
对于分页和增量采集,我们最终需要定义的是查询视图、迟提交数据的处理,以及变更位点代表什么。ID 的大小可以参与协议,却无法替我们决定这些规则。
正常发号之外,还有重启、回拨和恢复
一个生成器在稳定运行时可能只需要几行代码。保证能否延续,往往取决于它怎样处理运行状态的变化。
号段方案必须维护已分配上界:某个范围一旦被交付出去,其他生成器就不该再得到它。如果数据库恢复到旧状态,已经使用的号段就可能重新出现。因此,原子分配、上界持久化与恢复规则共同决定唯一性。
节点式方案则要覆盖身份的整个使用期间。假设 A 持有 worker=7 后长时间暂停,租约到期,B 获得同一个编号;随后 A 恢复,仍用旧状态发号。协调器的分配已经更新,旧进程却没有自动停止,新旧生成器就可能重用相同空间。
etcd 的官方 Jepsen 回顾说明过这种旧持有者访问外部资源的风险。 fencing token 能区分代际,但需要受保护的资源执行检查。用于发号节点时,还得明确旧代际由哪个资源端拒绝,或怎样通过不重叠空间隔离,以及恢复后能使用哪一段空间。
时钟回拨与序列耗尽也一样,需要定义具体动作:拒绝生成、等待、沿用逻辑时间,或者切换新的空间。每种动作都会改变可用性、延迟、时间含义或容量。随机方案则依赖随机源与生成器状态,进程复制、镜像克隆和快照恢复都应纳入其运行假设。
断网期间,要保留多少独立工作能力
手机或边缘节点可能需要先创建对象,联网后再同步。随机空间、预分配号段和节点空间都可以服务这种需求,只是可独立工作的条件不同:号段有余量限制,节点式要保留身份与分配状态,随机式依赖可靠随机源和概率模型。恢复后也需要避免复用已经消费的受管理空间。
如果两端离线修改同一对象,还需要版本、冲突检测和合并规则。为新对象产生不同的号码,只完成了同步问题的一部分。
因此,发号服务的评估要同时看尾延迟、余量、补充耗时、时钟偏差、重复检测、身份回收与恢复行为。本地计算吞吐、远端 RPC 吞吐,以及包含持久化的可靠交付吞吐,是不同的测量边界。
号码走出发号器以后,还会经过接口、日志、人工输入和排查工具。我们希望它不仅可用,也能提供一点帮助。
一个 ID 能在多大程度上“自证”
order_ 和 user_ 这样的前缀,先帮助人看出号码声称属于哪类对象。TypeID 将类型前缀与 UUIDv7 结合,服务的就是这种自描述需求;接口和类型系统再把这份提示落实为程序约束。
如果经常需要人工录入,还可以增加校验码来发现误输入。GitHub 在 2021 年的 token 格式设计中使用前缀与 CRC32,帮助离线 secret scanning 降低误报。这是凭证格式中可以借鉴的检错思路。CRC 的规则公开,主动构造者也能重算它,因此检错之后若还要验证发行关联,就需要另一种机制。
MAC 或数字签名让验证者能在相应密钥假设下检查完整性与密钥关联;MAC 的验证方若也持有密钥,同样具备生成能力。无状态验证可以省去部分查询,代价是长度、密钥分发、轮换与撤销管理。验证通过后,对象是否仍存在、号码是否已撤销、当前用户是否有权访问,仍由业务状态和授权机制决定。
内容寻址又换了一个证明对象。IPFS 的 CID 让引用绑定内容表示,拿到内容后可以校验匹配关系;它还受到分块、编码和 DAG 参数影响。这适合不可变内容。订单状态改变时,我们通常希望订单身份延续,可以另给内容或版本一个指纹,让稳定身份与版本身份各自承担责任。
从前缀到校验码,再到认证与内容校验,增加的信息各有用途,也会让 ID 更长、更容易被解释。对外发布时,这些优点就需要与隐私放在一起权衡。
对外公开以后,是否还该使用同一个号码
连续号码便于遍历,也可能提供发号规模的线索;空洞、取消和分配策略会让它与真实单量有偏差,却没有消除信息暴露。Snowflake 或 UUIDv7 弱化了直接相减估算数量的便利,同时公开了另一类线索,例如时间、节点或活动模式。
如果这些信息敏感,仅把数字改成 Base62、Base64,或者对低熵的小整数做公开哈希,并不足以隐藏规律。Sqids 也明确区分自身与加密能力。
这时,存储需求与公开需求开始冲突。一个直接的选择是分开:
id          BIGINT        内部记录主键
public_id   独立随机标识   外部引用,设置唯一约束
内部关联继续使用紧凑键,外部引用选择符合隐私要求的形式;将来拆库或迁移,也可以保持公开身份稳定。代价是新增唯一索引与转换查询。在 InnoDB 中,随机分布被放到了对应二级索引里,那份维护成本仍然存在。
业务稳定身份、公开引用和展示编号也可以进一步区分。客服口述需要较短、易输入且能检错的号码,机器接口可能更看重空间和不可预测性。需要几个字段,取决于这些职责能否共享同一组约束。
Shopify GID 用对象类型和号码形成跨接口引用,保留与 REST ID 的对应方式,体现的是引用层次的统一。 OpenID Connect 的 pairwise subject 则按 sector 提供不同标识,以降低第三方之间的直接关联。公开信息的多少、标识的稳定性,以及把同一个值交给哪些应用,会共同影响隐私。
难猜的号码还能提高盲目遍历的成本,但合法 ID 也可能经由链接、日志或转发流出。对象级权限检查仍需执行。
到这里,订单可能已经拥有内部主键、公开引用和展示号。它们进入后续的数据链路时,重要的事情又变成了:这些引用怎样保留下来。
离线重算时,我们反而不希望每次都发新号
订单进入数仓,会经历首次导入、增量同步、补数和全量重算。若每次都为每行生成新的随机 UUID,号码可以各不相同,同一订单却在下次运行后变成另一个身份,已有的关联、更新匹配和去重规则可能随之失效。
在线创建需要产生新身份,离线重算则常常需要认出已有身份。
任务内的行号能保留多久
Spark 的 monotonically_increasing_id() 生成唯一但不连续的值,实现依赖分区 ID 与分区内记录编号,因此是非确定的。重分区、输入或执行变化以后,行与号码的对应关系没有同样的稳定承诺。
排序后编号也需要固定数据集、稳定全序和明确并列规则。下次补进一条排在中间的数据,后续许多序号可能整体变化。它们适合相应结果中的定位,长期引用则需要更稳定的依据。
保留来源、保存映射,或者确定性派生
最直接的办法是保留来源键及其命名空间:
crm:customer:123
erp:customer:123
它先避免把不同来源的 123 误当成相同对象。两者是否真是同一个客户,还需要实体解析与业务规则。BytePlus CDP 的 ID-Mapping 就处理跨渠道标识的关联,解决的是身份对应,而不只是号码生成。
若下游更适合使用独立代理键,可以维护持久映射。代理键最初即使随机生成,只要来源与键的对应关系被保留,也能在重算时延续;需要支付的是并发写入、查找、备份,以及合并和拆分时的映射维护成本。
确定性派生则把对应规则放进计算。相同输入按相同算法得到相同结果,可以减少逐条登记,但首先要让输入表达没有歧义:
("ab", "c") 直接拼接为 abc
("a", "bc") 直接拼接也为 abc
在编码阶段已经合并的两个身份,哈希函数无法替我们分开。分隔符需要转义或约束,NULL 与空串、类型、字符编码、大小写、时区和字段顺序也需要约定。dbt 的 surrogate key 实践具体展示了拼接与 NULL 处理问题。
字段的业务含义同样重要。把地址、状态和整行内容一起参与计算,资料更新后结果就会变化,它更适合担当内容或版本指纹。稳定实体身份,应当选择相应稳定的输入或持久映射。
还需要为碰撞留出安排。BigQuery 的 FARM_FINGERPRINT 提供跨运行稳定的非密码 64 位结果。假设不同输入的输出近似独立且均匀,十亿个不同输入至少发生一次碰撞的生日近似概率约为 2.7%。这个模型估算说明,集合规模会改变“很难撞”的含义。
选择派生空间、保留原始身份、必要时检测碰撞,以及维护规则版本,都是可复算性的成本。更换规范化规则,也应像修改接口一样处理新旧对应关系。
同一个客户,为什么又需要多个版本键
客户迁到另一个地区,仍然是原来的客户;报表却可能需要下单时的地区。SCD Type 2 为同一个自然键保留多个历史版本,并用代理键区分这些版本行。
稳定客户 ID 与多个客户版本键因此可以并存。事实表引用哪个版本,由报表语义决定;全量重建时重新分配版本键,就可能破坏已有引用,这也是 Fabric 加载指南提醒谨慎清空重装此类维度表的原因。
断网生成与批处理重算,分别需要独立创建能力和身份延续能力。重算常常还伴随重放;同一份数据再次出现时,我们需要进一步判断,它是已有对象的新变化,还是同一次操作的重复尝试。
号码都唯一,业务仍然可能重复
客户端提交创建订单操作,服务端已成功提交,响应却丢失了。客户端重试时若又生成一个新的操作 ID,服务端可能把它识别为另一笔请求,再建一张订单。发号器按预期工作,业务却发生了重复。
这里涉及几层身份:订单是实体,创建和支付是不同操作,每次成功操作可以产生事件,事件又可能经历多次发布与投递。
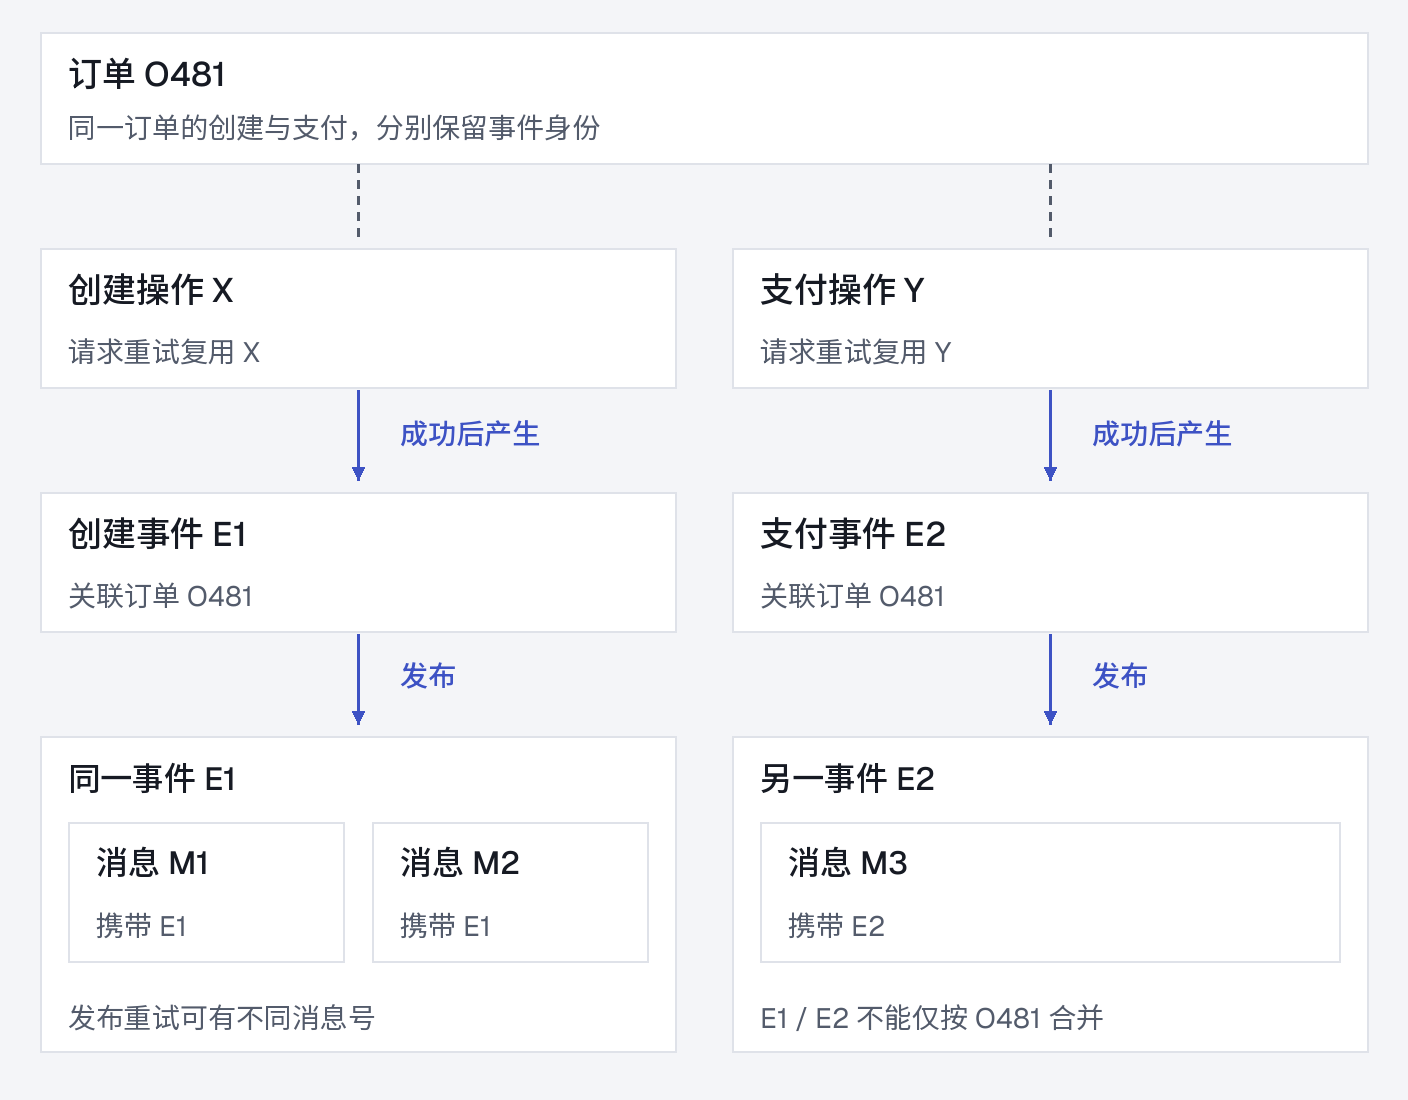
图 4:重试需要延续哪一层身份,取决于我们希望合并的是操作、事件还是传输记录。
同一操作的重试应按协议复用相应幂等键。Stripe API v1 通过保存首次执行的结果、识别重复键、检查参数一致性及规定保留行为,控制这类重复执行。
订单创建、支付、取消则通常具有不同事件身份,只按订单 ID 去重会误删合法变化。同一事件重新发布,又可能得到另一个传输消息 ID。Dataflow 与 Pub/Sub 的集成因此区分重复投递和业务记录重复发布:相应模式可以按消息 ID 处理前者,后者需要重试间一致的业务属性,并遵守连接器的去重窗口。
去重还需要状态:保存多久,是否允许历史重放,状态丢失后怎样恢复,都要进入协议。检查“未处理”与执行操作若不是受控的原子过程,并发请求仍可能同时通过。Kafka offset 则只识别相应分区内的记录,完整引用还需要 topic、partition 与数据集生命周期。
这也是 exactly-once 必须说明系统边界的原因。Dataflow 可以通过 checkpoint、输出身份与去重约束结果,重试仍可能多次执行用户代码,外部副作用需要相应系统配合。号码提供比较与记忆的依据,状态和提交协议负责把它落实为业务行为。
一个 ID 要活过多少次系统改造
号码进入日志、缓存、第三方数据库、邮件和收藏链接以后,就开始拥有比生成器更长的寿命。内部数据库可以更换,外部引用仍然需要找到原来的对象;分片迁到另一个机房,号码中的旧路由也需要继续被正确解释。
确定性派生规则升级,需要处理新旧键的对应;带认证能力的格式更换密钥,又会涉及轮换和撤销。越来越多的成本,发生在生成之后。
GitHub 的 Global ID 改造将可读性、内部路由与兼容放在一起考虑,官方迁移指南则要求客户端把 ID 作为不透明字符串使用。类型提示可以方便人排查,程序长期依赖哪些字段、能否自行构造或拆解,则应由公共接口明确承诺。
回到最初那张订单表,选择号码时需要留下的约定也就具体了:唯一性覆盖什么范围,哪些变化延续身份,哪些动作产生新身份,故障和重算后怎样恢复,旧引用由谁解释。这些条件会随业务变化,多种标识也可能在同一套系统里长期协作。
安排时间位、节点位、随机位和校验字段之前,先把这些约定说清楚,我们才能知道每一位换来了什么,以及后面需要维护什么。
参考阅读
- MySQL 8.4:Clustered and Secondary Indexes:主键宽度怎样进入二级索引。
- PostgreSQL 18:Index-Only Scans and Covering Indexes:索引与 heap 的存储关系。
- 美团:Leaf 分布式 ID 生成服务开源(2019):号段、预取与发号服务的工程实践。
- RFC 9562:Universally Unique IDentifiers(2024):UUIDv7 等格式与实现约定。
- PostgreSQL 18:UUID Functions:内置 UUIDv7 生成及时间、版本提取。
- Spanner:Schema Design Best Practices:递增键、范围分片与写入热点。
- TypeID 规范与实现:类型前缀与 UUIDv7 的组合。
- [OWASP:IDOR Prevention Cheat Sheet]
- Spark:monotonically_increasing_id:唯一、不连续与非确定性的具体含义。
- dbt:Generating Surrogate Keys Across Warehouses:拼接、NULL 与代理键派生。
- Microsoft Fabric:Dimension Tables:自然键、代理键与 SCD Type 2。
- Stripe:Idempotent Requests:幂等键的复用、参数检查与保留规则。
- Dataflow:Pub/Sub 集成与 Exactly-once:消息去重、结果提交与外部副作用。
- GitHub:Migrating GraphQL Global Node IDs:不透明引用与标识格式迁移。
还没有评论
可以在下面留下第一条。昵称和内容会公开显示。